No products in the cart.
Cyber News
ถอดบทเรียน TOR ภาครัฐด้าน DLP
28
Sep
Sep
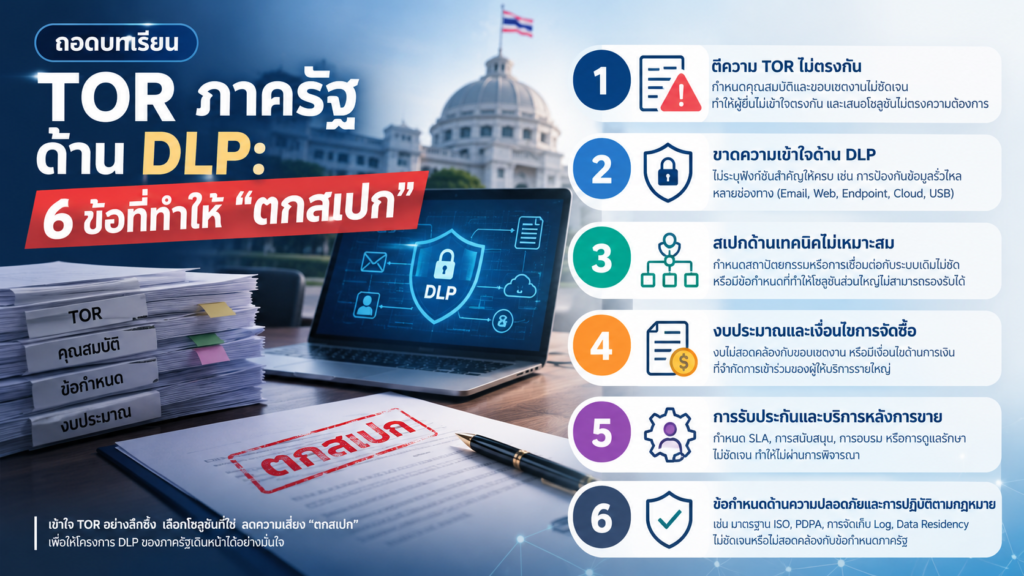
ถอดบทเรียน TOR ภาครัฐด้าน DLP: 6 ข้อที่ทำให้ “ตกสเปก” (เมื่อ Data Loss Prevention ไม่ใช่แค่ Endpoint)
DLP (Data Loss Prevention) เป็นหนึ่งในสเปก
ที่หน่วยงานภาครัฐไทยเริ่มใส่ใน TOR มากขึ้นเรื่อยๆ ตามแรงผลักดันของ PDPA และความกังวลเรื่องข้อมูลรั่วไหลจากภายในองค์กร แต่ต่างจาก Antivirus หรือ EDR ที่มาตรฐานการเทียบสเปกค่อนข้างนิ่งตัวแล้ว DLP ยังเป็นสนามที่ TOR ภาครัฐไทยเขียนสเปกได้หลากหลายรูปแบบมาก — และหลากหลายจนบางครั้งกลายเป็นกลไกที่ล็อกยี่ห้อโดยไม่รู้ตัวยิ่งกว่าสเปก Endpoint เดิมเสียอีก
จากมุมมองของคนที่ทำงาน pre-sales และวิเคราะห์เอกสาร comply TOR ด้าน security มาต่อเนื่อง นี่คือ 6 จุดที่ TOR ด้าน DLP มักทำให้โซลูชันที่ดีหลุดวงในตั้งแต่รอบคุณสมบัติ — และแนวทางรับมือที่ใช้ได้จริง
ภาพรวม: 6 จุดที่ควรอ่าน TOR ด้าน DLP ให้ทะลุ
| จุดที่ควรระวังใน TOR | สัญญาณที่สังเกตได้ | สิ่งที่ควรทำ |
| 1. ศัพท์เทคนิคเฉพาะเอนจิ้น Classification | ระบุชื่อเทคนิค fingerprinting/OCR เฉพาะวิธีเดียว | ถามว่าความต้องการจริงคือ “ตรวจจับข้อมูลแบบไหน” ไม่ใช่ “ใช้เทคนิคอะไร” |
| 2. ต้องครบ 3 ช่องทางในเคสเดียว (Endpoint+Network+Cloud) | Reference ต้องเป็นระบบเดียวที่คุม 3 ช่องทางพร้อมกัน | เสนอ reference แยกช่องทางที่ integrate กันได้ แทนระบบเดียวปิดทุกจุด |
| 3. Certification ไม่เกี่ยวการใช้งานจริง | ขอ Gartner MQ DLP หรือ ICSA Labs เป็นคุณสมบัติ | ชี้ผลทดสอบ false positive/negative จริงในบริบทภาษาไทยแทน |
| 4. ทีมในประเทศนับ “อายุบริษัท” แทนความสามารถ tuning | ต้องมีสำนักงาน/ทีม 3-5 ปี | เสนอแผน policy tuning เฉพาะบริบทไทย (เลขบัตร ปชช., เลขบัญชี) ให้ชัด |
| 5. ราคาต่ำสุดที่มองข้ามผลกระทบ False Positive | สเปกกว้าง ตัดสินราคาอย่างเดียว | ผลักดันเกณฑ์ “คะแนนเทคนิค + ราคา” โดยใส่ตัวชี้วัด accuracy เข้าไปด้วย |
| 6. TOR ก็อปปี้จาก Brochure + ผูก Data Residency เฉพาะแบรนด์ | ถ้อยคำคุ้นเหมือนโบรชัวร์ พร้อมระบุ integration เจาะจงระบบเดิม | เข้าร่วมขั้นตอนรับฟังความเห็นร่าง TOR ตั้งแต่ต้น |
1. สเปกที่ “ล็อกยี่ห้อ” ด้วยศัพท์เทคนิคเฉพาะเอนจิ้น Classification
DLP แต่ละเจ้าใช้เทคนิคตรวจจับและจำแนกข้อมูลต่างกัน ทั้ง exact data matching, fingerprinting, OCR สำหรับภาพและเอกสารสแกน, หรือ machine learning classification บาง TOR เขียนสเปกโดยระบุชื่อเทคนิคเฉพาะแบบที่มีผู้ผลิตเพียงรายเดียวทำได้ตามนั้นจริง ทั้งที่โจทย์ทางธุรกิจเบื้องหลังอาจแก้ได้ด้วยหลายเทคนิคผสมกัน
สิ่งที่ต้องทำคือย้อนกลับไปถามเจ้าของ TOR ว่า “ข้อมูลประเภทไหนที่ต้องการป้องกัน” (เลขบัตรประชาชน, เลขบัญชี, เอกสารลับ) ไม่ใช่เถียงว่าเทคนิคไหนดีกว่ากัน
เคล็ดลับ: เตรียมตัวอย่างผลทดสอบการตรวจจับข้อมูลภาษาไทย (เลขบัตร ปชช. 13 หลัก, เลขบัญชีธนาคาร, ชื่อ-นามสกุลไทย) ไว้เปรียบเทียบชัดๆ เพราะเทคนิคที่ TOR ระบุอาจไม่ได้ optimize กับข้อมูลภาษาไทยเลย
2. ข้อกำหนดให้ระบบเดียวคุมครบ 3 ช่องทาง (Endpoint + Network + Cloud) ในเคสเดียว
TOR จำนวนไม่น้อยกำหนดว่า reference site ต้องเป็นหน่วยงานที่ใช้ DLP ตัวเดียวคุมทั้ง Endpoint DLP, Network DLP และ Cloud/Email DLP พร้อมกันในโครงการเดียว ซึ่งฟังดูสมเหตุสมผลเรื่อง ecosystem แต่ในทางปฏิบัติ มีผู้ผลิตไม่กี่รายที่มี reference ครบทั้ง 3 ช่องทางในโครงการภาครัฐไทยเดียวกัน ทั้งที่การ integrate โซลูชันเฉพาะทางแต่ละช่องทางเข้าด้วยกันอาจตอบโจทย์ได้ดีกว่าด้วยซ้ำ
จุดที่ควรเจรจาคือขอให้แยกนับ reference รายช่องทางได้ พร้อมแสดงสถาปัตยกรรมการ integrate ผ่าน API หรือ console กลาง แทนการบังคับว่าต้องเป็นผู้ผลิตเดียวกันทั้งหมด
3. การรับรอง (Certification) ที่ไม่สะท้อนการใช้งานจริงในบริบทไทย
Gartner Magic Quadrant สำหรับ DLP หรือรายงานจาก ICSA Labs มักถูกหยิบมาเป็นเงื่อนไขคุณสมบัติ ทั้งที่รายงานเหล่านี้ทดสอบบนชุดข้อมูลและ use case แบบสากล ไม่ได้วัด accuracy กับรูปแบบข้อมูลไทยโดยเฉพาะ เช่น เลขบัตรประชาชน 13 หลัก, รูปแบบเลขบัญชีธนาคารไทย, หรือชื่อ-ที่อยู่ภาษาไทยที่มีการเว้นวรรคไม่แน่นอน
ผลคือโซลูชันภูมิภาคที่ tune ให้จับรูปแบบข้อมูลไทยได้แม่นกว่า อาจหลุดจากเกณฑ์นี้ทั้งที่ประสิทธิภาพจริงในบริบทไทยดีกว่า
4. ข้อกำหนดทีมในประเทศ ที่นับ “อายุบริษัท” แทน “ความสามารถ Tuning นโยบาย”
DLP ต่างจาก Endpoint ตรงที่ implementation ไม่จบแค่ติดตั้ง แต่ต้องมีการ tuning policy ต่อเนื่องเพื่อลด false positive (บล็อกข้อมูลที่ไม่ควรบล็อก) และ false negative (ปล่อยข้อมูลที่ควรบล็อกหลุดออกไป) ซึ่งต้องอาศัยทีมที่เข้าใจ workflow และรูปแบบข้อมูลขององค์กรไทยจริงๆ แต่ TOR จำนวนมากยังตั้งเงื่อนไขแบบเดิมคืออายุบริษัทหรือจำนวนวิศวกรขั้นต่ำ
วิธีรับมือคือเตรียมแผน policy tuning ระยะ 90 วันแรกหลังติดตั้งให้ชัดเจน ระบุขั้นตอนการวัดผล false positive/negative และการปรับจูนตามรอบ แทนที่จะแข่งแค่ “อายุบริษัท”
5. เกณฑ์ราคาต่ำสุด (E-bidding) ที่มองข้ามผลกระทบจาก False Positive
นี่คือกับดักเฉพาะของ DLP ที่ต่างจาก Endpoint ชัดเจน — ถ้า TOR เขียนสเปกกว้างแล้วตัดสินด้วยราคาต่ำสุด หน่วยงานอาจได้ระบบที่ “ตรวจจับได้” ตามสเปกขั้นต่ำ แต่มี false positive สูงจนพนักงานทำงานไม่ได้ (ไฟล์ปกติถูกบล็อกตลอด) หรือ false negative สูงจนข้อมูลสำคัญรั่วออกไปโดยไม่มีการแจ้งเตือน ซึ่งเป็นความเสี่ยงที่ประเมินเป็นตัวเงินยากกว่าเรื่องประสิทธิภาพของ Endpoint ทั่วไป
บทเรียนตรงนี้คือควรผลักดันให้ TOR ใส่ตัวชี้วัด accuracy (เช่น อัตรา false positive ที่ยอมรับได้) เป็นส่วนหนึ่งของคะแนนเทคนิค ไม่ใช่แค่ “มี/ไม่มี” ฟีเจอร์
6. TOR ก็อปปี้จาก Brochure ของเจ้าเดิม พร้อมผูก Data Residency เฉพาะแบรนด์
ข้อสุดท้ายที่พบเฉพาะใน DLP คือ TOR บางฉบับนอกจากจะมีถ้อยคำคุ้นเหมือนโบรชัวร์แล้ว ยังระบุเงื่อนไข Data Residency หรือการ integrate กับระบบ log/SIEM เดิมแบบเจาะจงจนเหลือผู้ผลิตเดียวที่ทำได้ตามนั้น ทั้งที่ประเด็น Data Residency ควรเขียนเป็นข้อกำหนดเชิงนโยบาย (เช่น ข้อมูลต้องเก็บในประเทศไทย) ไม่ใช่เขียนแบบระบุเทคนิคการ integrate เฉพาะเจ้า
วิธีที่ได้ผลที่สุดยังเหมือนเดิมคือเข้าร่วมขั้นตอนรับฟังความคิดเห็นร่าง TOR (ถ้ามี) และเสนอมุมมอง use case จริงขององค์กร
Checklist: ก่อนยื่นข้อเสนอ TOR ภาครัฐด้าน DLP ครั้งหน้า
ขั้นก่อนประกาศ TOR (ถ้ามีช่องทางร่วมให้ความเห็น) – ติดตามประกาศร่าง TOR ของหน่วยงานเป้าหมายอย่างสม่ำเสมอ – ส่งความเห็นเป็นลายลักษณ์อักษรทันทีที่พบชื่อเทคนิค classification เฉพาะแบรนด์ – เสนอมุมมอง use case จริง (ประเภทข้อมูลที่ต้องป้องกัน) แทนการเสนอสเปกฟีเจอร์ตรงๆ
ขั้นอ่าน TOR ที่ประกาศแล้ว – ไล่เช็คทุกข้อสเปกเทียบกับ Checklist 6 ข้อนี้ – แยกให้ออกว่าเงื่อนไขไหนคือ “ล็อกสเปก” กับเงื่อนไขไหนคือ “ความเสี่ยงที่สมเหตุสมผล” (เช่น Data Residency ที่เขียนเป็นนโยบายทั่วไป) – เตรียมคำถามเรื่อง accuracy/false positive rate ส่งเข้าสู่กระบวนการชี้แจง TOR เป็นลายลักษณ์อักษรเสมอ
ขั้นเตรียมข้อเสนอ – เตรียมแผน policy tuning 90 วันแรก พร้อมตัวชี้วัดวัดผล false positive/negative – รวบรวมผลทดสอบการตรวจจับข้อมูลภาษาไทยไว้เปรียบเทียบชัดๆ – เก็บบันทึกทุกครั้งที่พบ TOR ล็อกสเปกด้าน DLP ไว้ใช้เป็นข้อมูลอ้างอิงหรือยื่นอุทธรณ์หากจำเป็น
สรุป
DLP เป็นสเปกที่ TOR ภาครัฐไทยยังเขียนได้หลากหลายและคลาดเคลื่อนได้ง่ายกว่า Endpoint เพราะยังไม่มีมาตรฐานการเทียบสเปกที่นิ่งตัว ทีมขายและทีมเทคนิคที่เข้าใจกลไกทั้ง 6 ข้อนี้ โดยเฉพาะประเด็นเฉพาะของ DLP อย่าง false positive/negative และ Data Residency จะสามารถเข้าไปมีบทบาทตั้งแต่ขั้นตอนก่อนออกประกาศจัดซื้อ ซึ่งเป็นจุดที่ตัดสินผลแพ้ชนะมากกว่าวันยื่นซองจริงเสียอีก
หมายเหตุผู้เขียน: บทความนี้เรียบเรียงจากมุมมองและประสบการณ์ pre-sales ด้าน endpoint/security compliance กับ TOR ภาครัฐไทย ต่อยอดหลักการเดียวกับบทความ “ถอดบทเรียน TOR ภาครัฐด้าน Endpoint” มาปรับใช้กับ DLP โดยเฉพาะ ไม่ได้อ้างอิงเคสหรือหน่วยงานใดหน่วยงานหนึ่งเป็นการเฉพาะ
ติดต่อ Skysoft ได้เลย — ทีมงานพร้อมตอบทุกคำถามโดยไม่มีค่าใช้จ่าย
พร้อมประเมินความเสี่ยงด้านความปลอดภัยขององค์กรของคุณหรือยัง?
ติดต่อทีมผู้เชี่ยวชาญ WatchGuard เพื่อรับคำแนะนำเฉพาะสำหรับธุรกิจของคุณได้วันนี้
หากท่านสนใจทดลองใช้สามารถ ลงทะเบียนเพื่อขอทดลองได้ฟรี 30 วัน
Credit https://www.watchguard.com
